
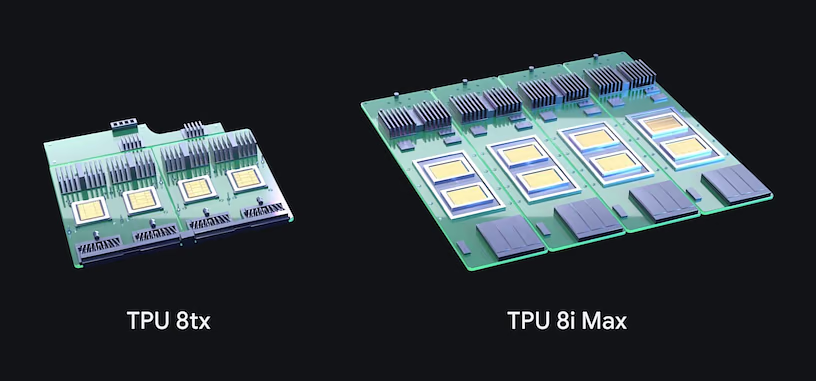
Google presentó en abril la octava generación de sus TPU, unidades de procesamiento tensorial que conforman las aceleradoras de sus centros de datos. Ahora ha anunciado dos variantes más pensadas para los agentes de IA, la 8tx y la 8i Max, principalmente centradas en ofrecer una privacidad reforzada de la información que procesarán y para mayores ventanas de contexto durante la inferencia. La novedad es que ha añadido los comentarios de sus clientes para crear soluciones a su medida, en lugar de dejarlo en manos de DeepMind, su filial de IA.
La 8tx usa el mismo chip que la 8t, pero se utiliza junto a procesadores EPYC de quinta generación en los servidores. Incluye seguridad por hardware que protege los datos y los pesos del modelo mientras se realizan inferencias. También sirve para entrenamiento a pequeña escala. Usa la red de baja latencia Boardfly de la 8i para razonamiento en tiempo real. Reduciría hasta a la mitad la latencia de la 8t sin apenas perder rendimiento por la seguridad añadida.
Por otro lado, la 8i Max une dos chips 8i en un mismo encapsulado, con lo que duplica la capacidad de cómputo, la SRAM (básicamente la caché del chip) y el ancho de banda de la HBM de la aceleradora. Cada 8i tiene 384 MB de SRAM, así que la 8i Max tendría 768 MB. Como ocupa el mismo espacio que la 8i en el bastidor, permite meter el doble de capacidad de cómputo en el mismo espacio del centro de datos. Esta intenta solucionar el problema de la cantidad de memoria disponible para ejecutar un gran modelo de lenguaje, y aumenta el contexto que pueden mantener los agentes de IA.
Vía: Wccftech.